Enunciado, Qué Tan Fielmente los Modelos de Lenguaje Convierten un Enunciado en un Modelo Resoluble
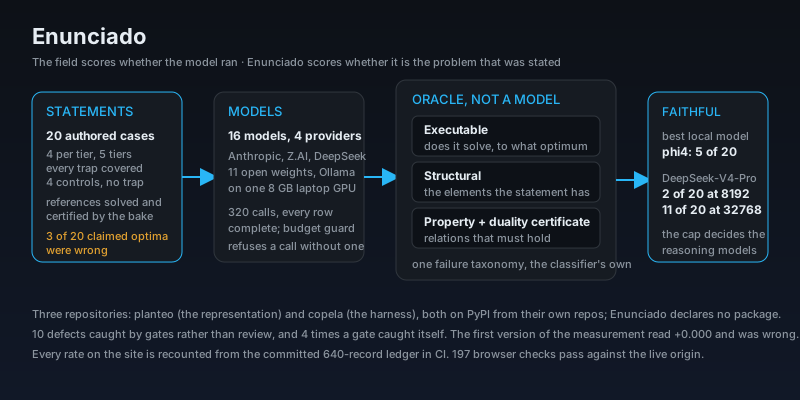
El campo reporta si el modelo generado corrió y a eso lo llama correcto. Enunciado mide fidelidad en su lugar: un corpus de 20 enunciados de optimización redactados a mano en cinco niveles de complejidad, con cada trampa cubierta y cuatro controles sin trampa, se entrega a modelos de lenguaje, y el modelo formal que cada uno devuelve lo juzga un oráculo que no es un modelo de lenguaje: capas ejecutable, estructural y de propiedades sobre un solver, con un certificado de dualidad. Dieciséis modelos de cuatro proveedores, 320 llamadas, todas las filas completas. El mejor modelo local, phi4, es fiel en 5 de 20. El tope de salida decide a los modelos de razonamiento: DeepSeek-V4-Pro es fiel en 2 de 20 con 8192 tokens y en 11 de 20 con 32768. La primera versión de esta medición marcaba +0,000 y estaba equivocada.
Contexto de Negocio
Cualquiera que entregue una optimización, una simulación o un diseño de experimento a un modelo de lenguaje necesita saber con qué frecuencia el modelo devuelto es el problema que planteó, y no solo un modelo que resuelve. Enunciado da ese número por modelo, por nivel y por trampa, con las advertencias unidas al mismo libro de registro, para que un equipo pueda elegir un modelo para una tarea de formalización por fidelidad medida y no por una tabla de posiciones que puntuó compilación. También muestra qué mueve el número: el tope de salida decide a los modelos de razonamiento, la vía local desplaza en silencio su contexto por defecto, y una refutación metamórfica puede ser un candidato no acotado mal leído por tres capas, cada uno un hallazgo registrado y no una nota al pie.
Valor Estratégico
El producto es el primer adoptante de un arquetipo de medición de narrativa a formal, y su registro de lo que atraparon las compuertas es su argumento más fuerte. Diez defectos fueron atrapados por compuertas y no por revisión: tres óptimos declarados equivocados; un envoltorio de solver que lanzaba una excepción en el caso deliberadamente infactible en lugar de reportar infactibilidad; dos barridos que compartían un libro y entrelazaban registros de versiones de código distintas; un reporte que imprimía una brecha de +0,000 cuando quería decir sin medición; nombres de proveedores encontrados en la CLI por la prueba de la costura; un enlace profundo que respondía 404 mientras renderizaba correctamente. Cuatro veces una compuerta se atrapó a sí misma: la guarda del documento de diseño leyó una referencia cruzada en prosa como un requisito duplicado, la compuerta de UI aprobó su chequeo de artefactos cargados mientras la página mostraba un error del router, su cambio de tema escribía una clave que nada lee así que ambas pasadas corrieron en un tema, y su servidor de pruebas modelaba mal el host de dos formas distintas. Ambas brechas de Claude de +0,050 descansan en una sola refutación cada una que cae exactamente en el óptimo entero de la referencia en un enunciado que nunca fija integralidad; leídas como permitidas son 0,000, la página lo dice, y la definición es una decisión registrada. Las otras familias objetivo (modelado matemático y de simulación, diseño de experimentos, encuadre de aprendizaje automático), los manuscritos y cualquier medición de un modelo de frontera más allá de los dieciséis no están construidos y no se afirman. El release 0.08.000 puso las seis páginas en el orden del estándar con App primero, dividió la Comparativa en seis pestañas y escribió la superficie en español con sus acentos, 1.813 palabras decididas en contexto.
El Desafío
Enunciado es la palabra para el planteamiento de un problema: el texto tal como se entrega, antes de que alguien decida cuáles son las variables. Convertirlo en un modelo formal y resoluble es el paso que las evaluaciones publicadas se saltan. Cuatro literaturas separadas reportan que el artefacto corrió y a eso lo llaman correcto, y cada una, leída de cerca, admite que la fidelidad medida es menor: en modelado de optimización, alcanzar el objetivo de referencia no implica un modelo correcto (arXiv:2508.10047); en formalización de enunciados hay una brecha de 3,0 a 29,0 puntos entre compilar y ser fiel, con el agente más fuerte compilando el 89,5 por ciento de las veces y siendo fiel el 60,5 (arXiv:2606.31002); en diseño de experimentos todo modelo es débil en datasets, líneas base y métricas (arXiv:2608.03501); en modelado de simulación el modelo corre pero el razonamiento causal es débil y ningún modelo domina (arXiv:2605.28994). Un artículo de posición de 2025 sostiene que es un solo problema y no entrega nada de la maquinaria (arXiv:2509.09810). Los benchmarks de la comunidad no sirven: cargan tasas de error de 8,13 a 54,0 por ciento, dos de los más citados no pueden redistribuirse por licencia, y la familia vecina de aprendizaje automático está contaminada.
Nuestro Enfoque
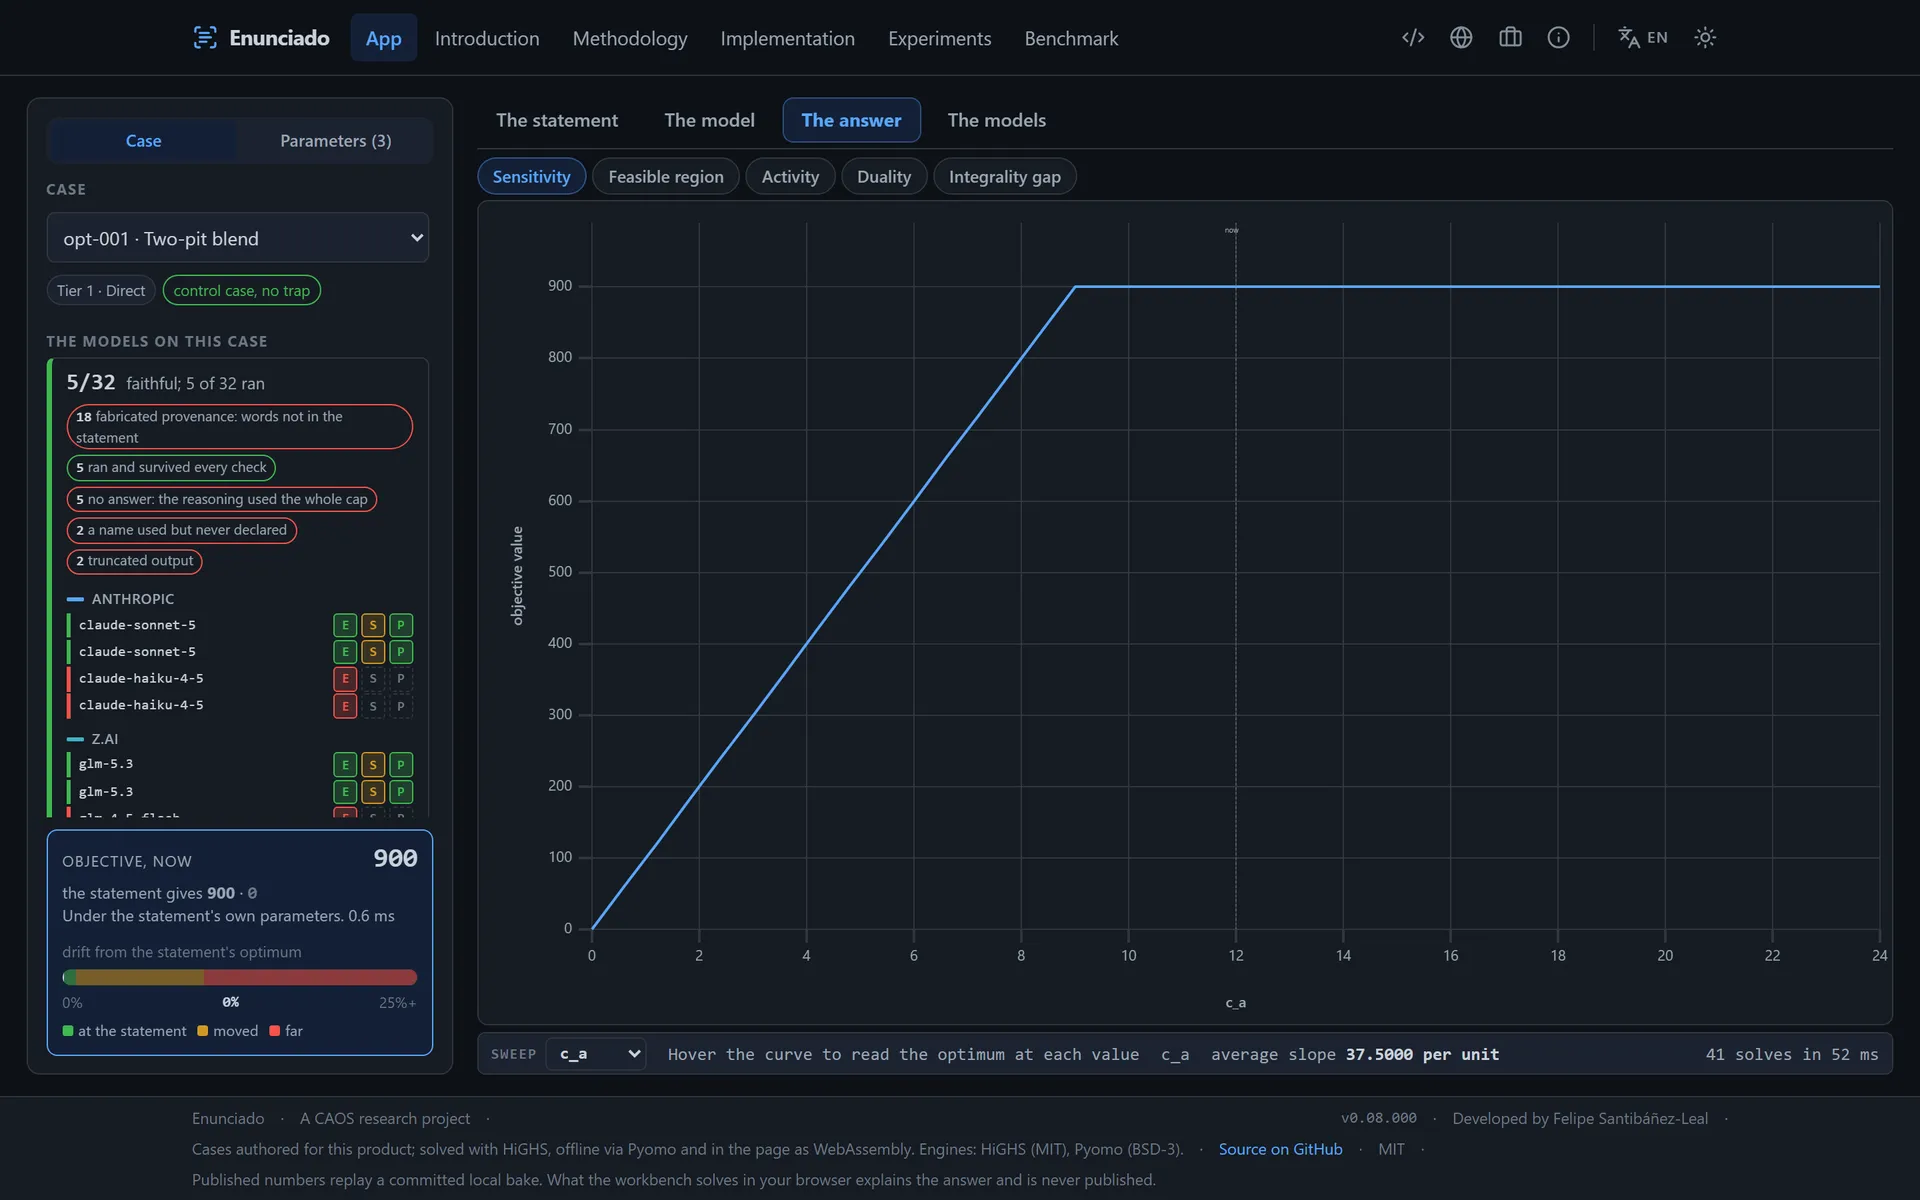
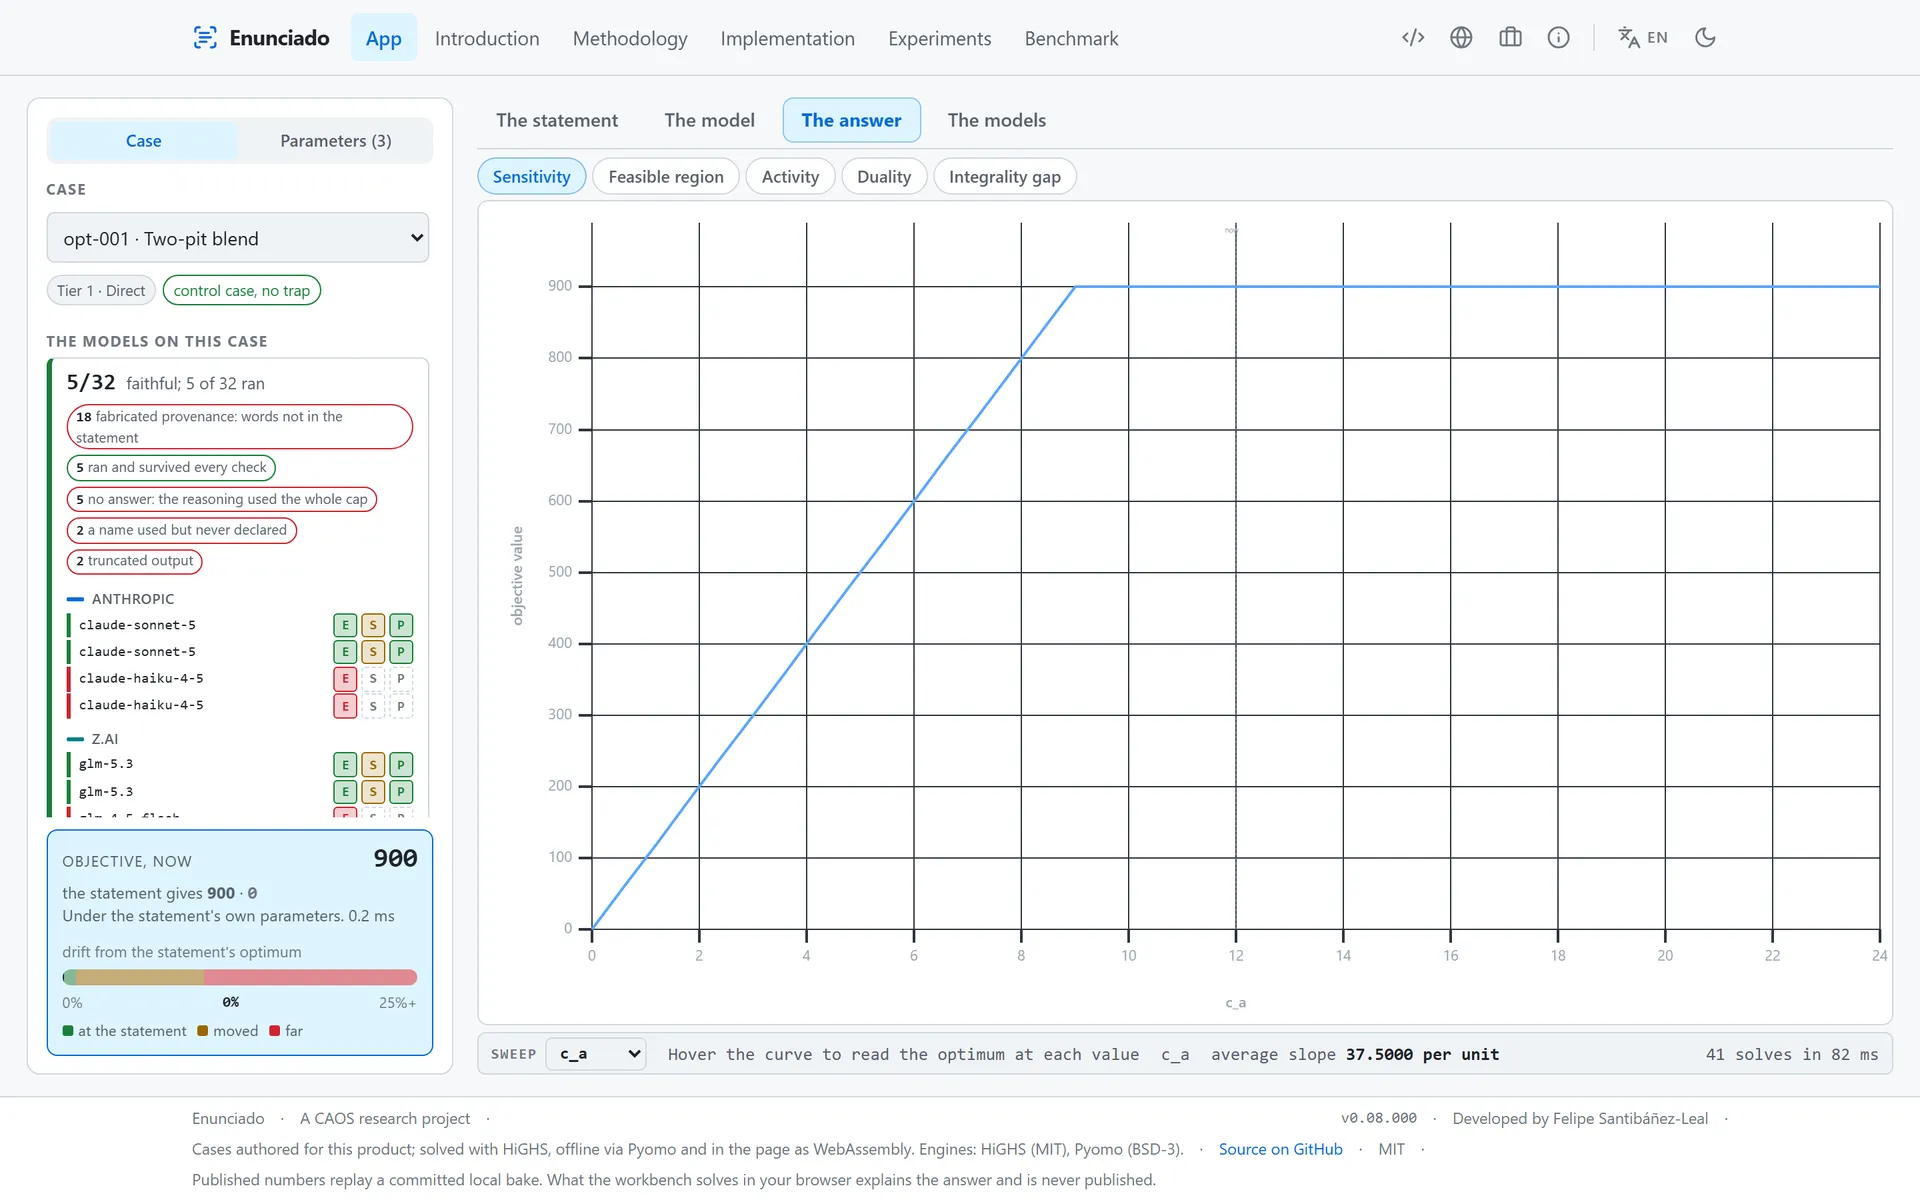
Tres repositorios, un producto. planteo (su propio repositorio, en PyPI) es la representación: dimensiones en cada cantidad, procedencia en cada elemento y un registro de lo que el enunciado dejó abierto. copela (su propio repositorio, en PyPI) es el arnés: una costura de proveedor, un libro de registro de solo anexar, cuatro capas de veredicto y una guarda de presupuesto que se niega a llamar a un modelo sin un presupuesto declarado. Enunciado es el producto y no declara paquete: el corpus, el horneado, la medición y la superficie web. El corpus son 20 casos redactados a mano, cuatro por nivel en cinco niveles de complejidad, con cada trampa cubierta y cuatro controles sin trampa, escritos en lugar de importados por las razones anteriores. El horneado verifica que cada referencia resuelve, que cada óptimo declarado coincide con el solver y que cada relación de propiedades se cumple en la referencia; atrapó tres óptimos declarados equivocados de veinte. La medición llama a dieciséis modelos de cuatro proveedores (Anthropic, Z.AI, DeepSeek y once modelos de pesos abiertos a través de Ollama en una sola GPU de laptop de 8 GB), 320 llamadas con todas las filas completas en un libro de 640 registros, y puntúa cada respuesta a través de las capas ejecutable, estructural y de propiedades con una sola taxonomía de fallas igual a la del clasificador. El banco de trabajo muestra catorce métodos en cuatro grupos, una pestaña de Dualidad que es un certificado de optimalidad en cuatro partes, una barra lateral que diagnostica el caso seleccionado desde el libro, matrices de modelos, una tabla de sensibilidad al tope y advertencias calculadas desde el libro en lugar de escritas.
Indicadores Clave de Rendimiento
| KPI | Línea Base | Resultado | Impacto |
|---|---|---|---|
| Fidelidad, no compilación | Las evaluaciones publicadas puntúan si el modelo corrió | Capas ejecutable, estructural y de propiedades sobre un solver, con un certificado de dualidad en cuatro partes; el mejor modelo local, phi4, es fiel en 5 de 20 casos | Un modelo se elige por lo que acertó, no por lo que devolvió |
| El tope decide a los modelos de razonamiento | Un solo número por modelo | DeepSeek-V4-Pro es fiel en 2 de 20 con un tope de salida de 8192 tokens y en 11 de 20 con 32768; se publican la tabla de sensibilidad al tope y los conteos al tope | Un ranking sin su tope no es un resultado |
| Una medición que se corrigió a sí misma | El primer reporte marcaba una brecha de +0,000 | Quería decir sin medición; el reporte ahora distingue ambas cosas, y el release 0.07.001 volvió a derivar reporte, intentos y repuntuación después de que CI encontró que los artefactos cubrían 551 llamadas contra un libro de 640 registros | Cada tasa del sitio se recuenta desde el libro versionado en CI |
Arquitectura
enunciado pipeline
Stack Tecnológico
Capturas de la Aplicación